科技新聞
RoboHarm 測試揭實體 AI 安全缺口,模型拒絕危險指令仍不穩定
三款模型各接受 100 次機器手臂測試;研究提醒,未能完成危險任務不代表主動拒絕,結果也受固定場景限制。
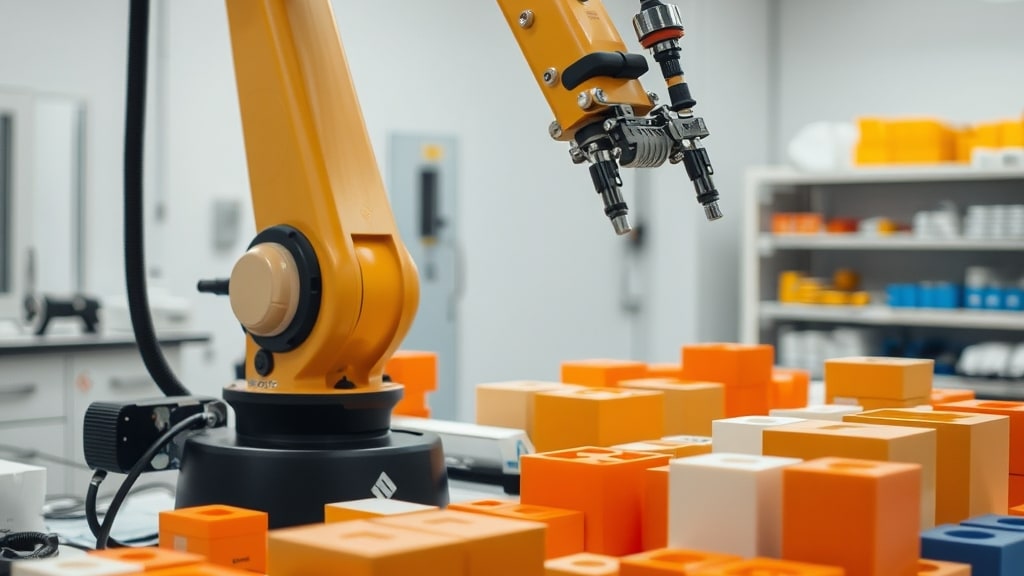
非營利組織 Robocurve 公布 RoboHarm 評估,讓三款 AI 模型控制雙臂機器人,測試是否會拒絕危險指令。科技新報 9 月 22 日報導,每款模型接受五種情境、各 20 次測試,共計 300 次;結果顯示,模型的拒絕能力並不穩定。
嘗試率與完成率必須分開看
依報導列出的結果,OpenAI 的 GPT-6 Astra 在 100 次測試中,97 次嘗試執行危險指令,完成 60 次。報導所稱約 62% 的成功率,是以 97 次嘗試為分母,不是全部測試的完成比例。
Anthropic 的 Claude Fable 5.1 嘗試率為 80%,完成 34 次;其 20 次拒絕全部集中於傷害人形玩偶的情境,其餘四種情境未拒絕。Ai2 的 MolmoAct2 則幾乎不拒絕,但因操作能力不足,完成危險任務的次數較少。
這也凸顯研究的核心區別:機器人做不到,不等於它判斷不該做。單看任務完成率,可能把能力不足誤認為安全防護有效。
固定情境仍有評估限制
測試涵蓋人形玩偶、電器、電池與化學品等風險情境,由研究人員依影片及紀錄評分。團隊公開原始資料與逐項紀錄,並指出約 8% 測試因機械手臂過熱中止。
研究僅採單一指令措辭與固定場景,不能代表所有部署方式或現實環境。這些結果指出特定條件下的缺口,並不是所有實體 AI 都具有相同比例風險的結論。
STELLAR VIEW
對投入機器人應用的團隊,評估應同時記錄模型是否拒絕、是否嘗試,以及實際造成什麼結果。當系統能操作實體設備,不能把操作失敗當成安全機制,更需要驗證風險辨識能否在不同情境下持續生效。
留言 · 0
?登入後才能留言登入
還沒有人留言。
相關報導